智慧型自動化壓力測試系統:目標功率建模與多維度結果分析
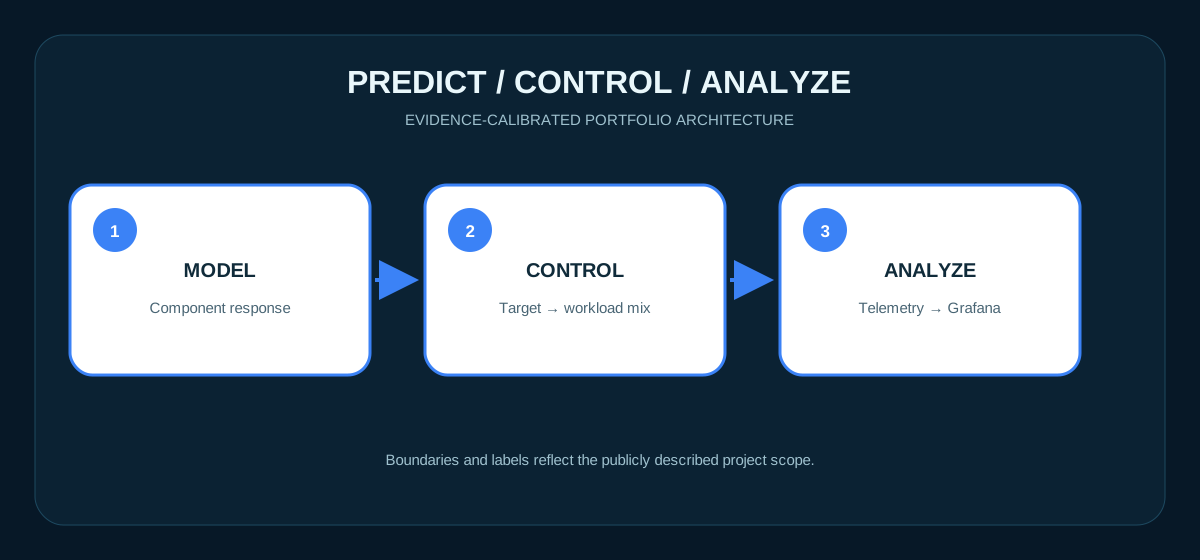
本專案是一套以 Golang agent/controller 為核心的分散式伺服器壓力測試系統。它先從 pre-test 建立元件負載與功率反應,再依目標瓦數推估 workload 組合;測試期間保存 telemetry 與 log,最後透過 Grafana 圖表與選配的 AI 輔助模組協助人工回顧長時間結果。
此案例屬於我的研華軟體工程作品集。公開內容只呈現方法、架構與已公開圖表,不包含設備組態、實際 workload 指令、模型係數、內部門檻或測試資料。
兩個工程問題:如何施壓,以及如何判讀
固定 burn-in script 能製造高負載,卻不一定能讓整機功率接近指定目標。CPU、Memory、Ethernet、GPU 與 storage I/O 的功率反應也不同,單純把每個 workload 設為相同比例,無法保證得到想要的 system wattage。
另一方面,長時間測試會同時產生溫度、fan speed、power、frequency 與 throttling 等資料。若只逐張查看 time-series chart,很難快速比較負載區間、停留時間與可能的散熱異常。
因此我把系統分成兩條互補路徑:Predict/Control 負責建立刺激條件,Analyze 負責整理與回顧反應。
分散式執行架構
- Golang CLI Agent: 部署在 SUT,負責執行已選定的底層 workload、收集狀態與保存 log。原設計包含本地 log buffering,以降低暫時斷線造成資料遺失的風險;公開資料未提供 recovery test。
- Controller: 管理一對多連線、測試命令與預約排程,接收 agent 回傳的狀態與資料。
- Telemetry / Analysis: 將測試資料送入 Grafana dashboard,並保留交給 AI 模組做輔助解讀的介面。
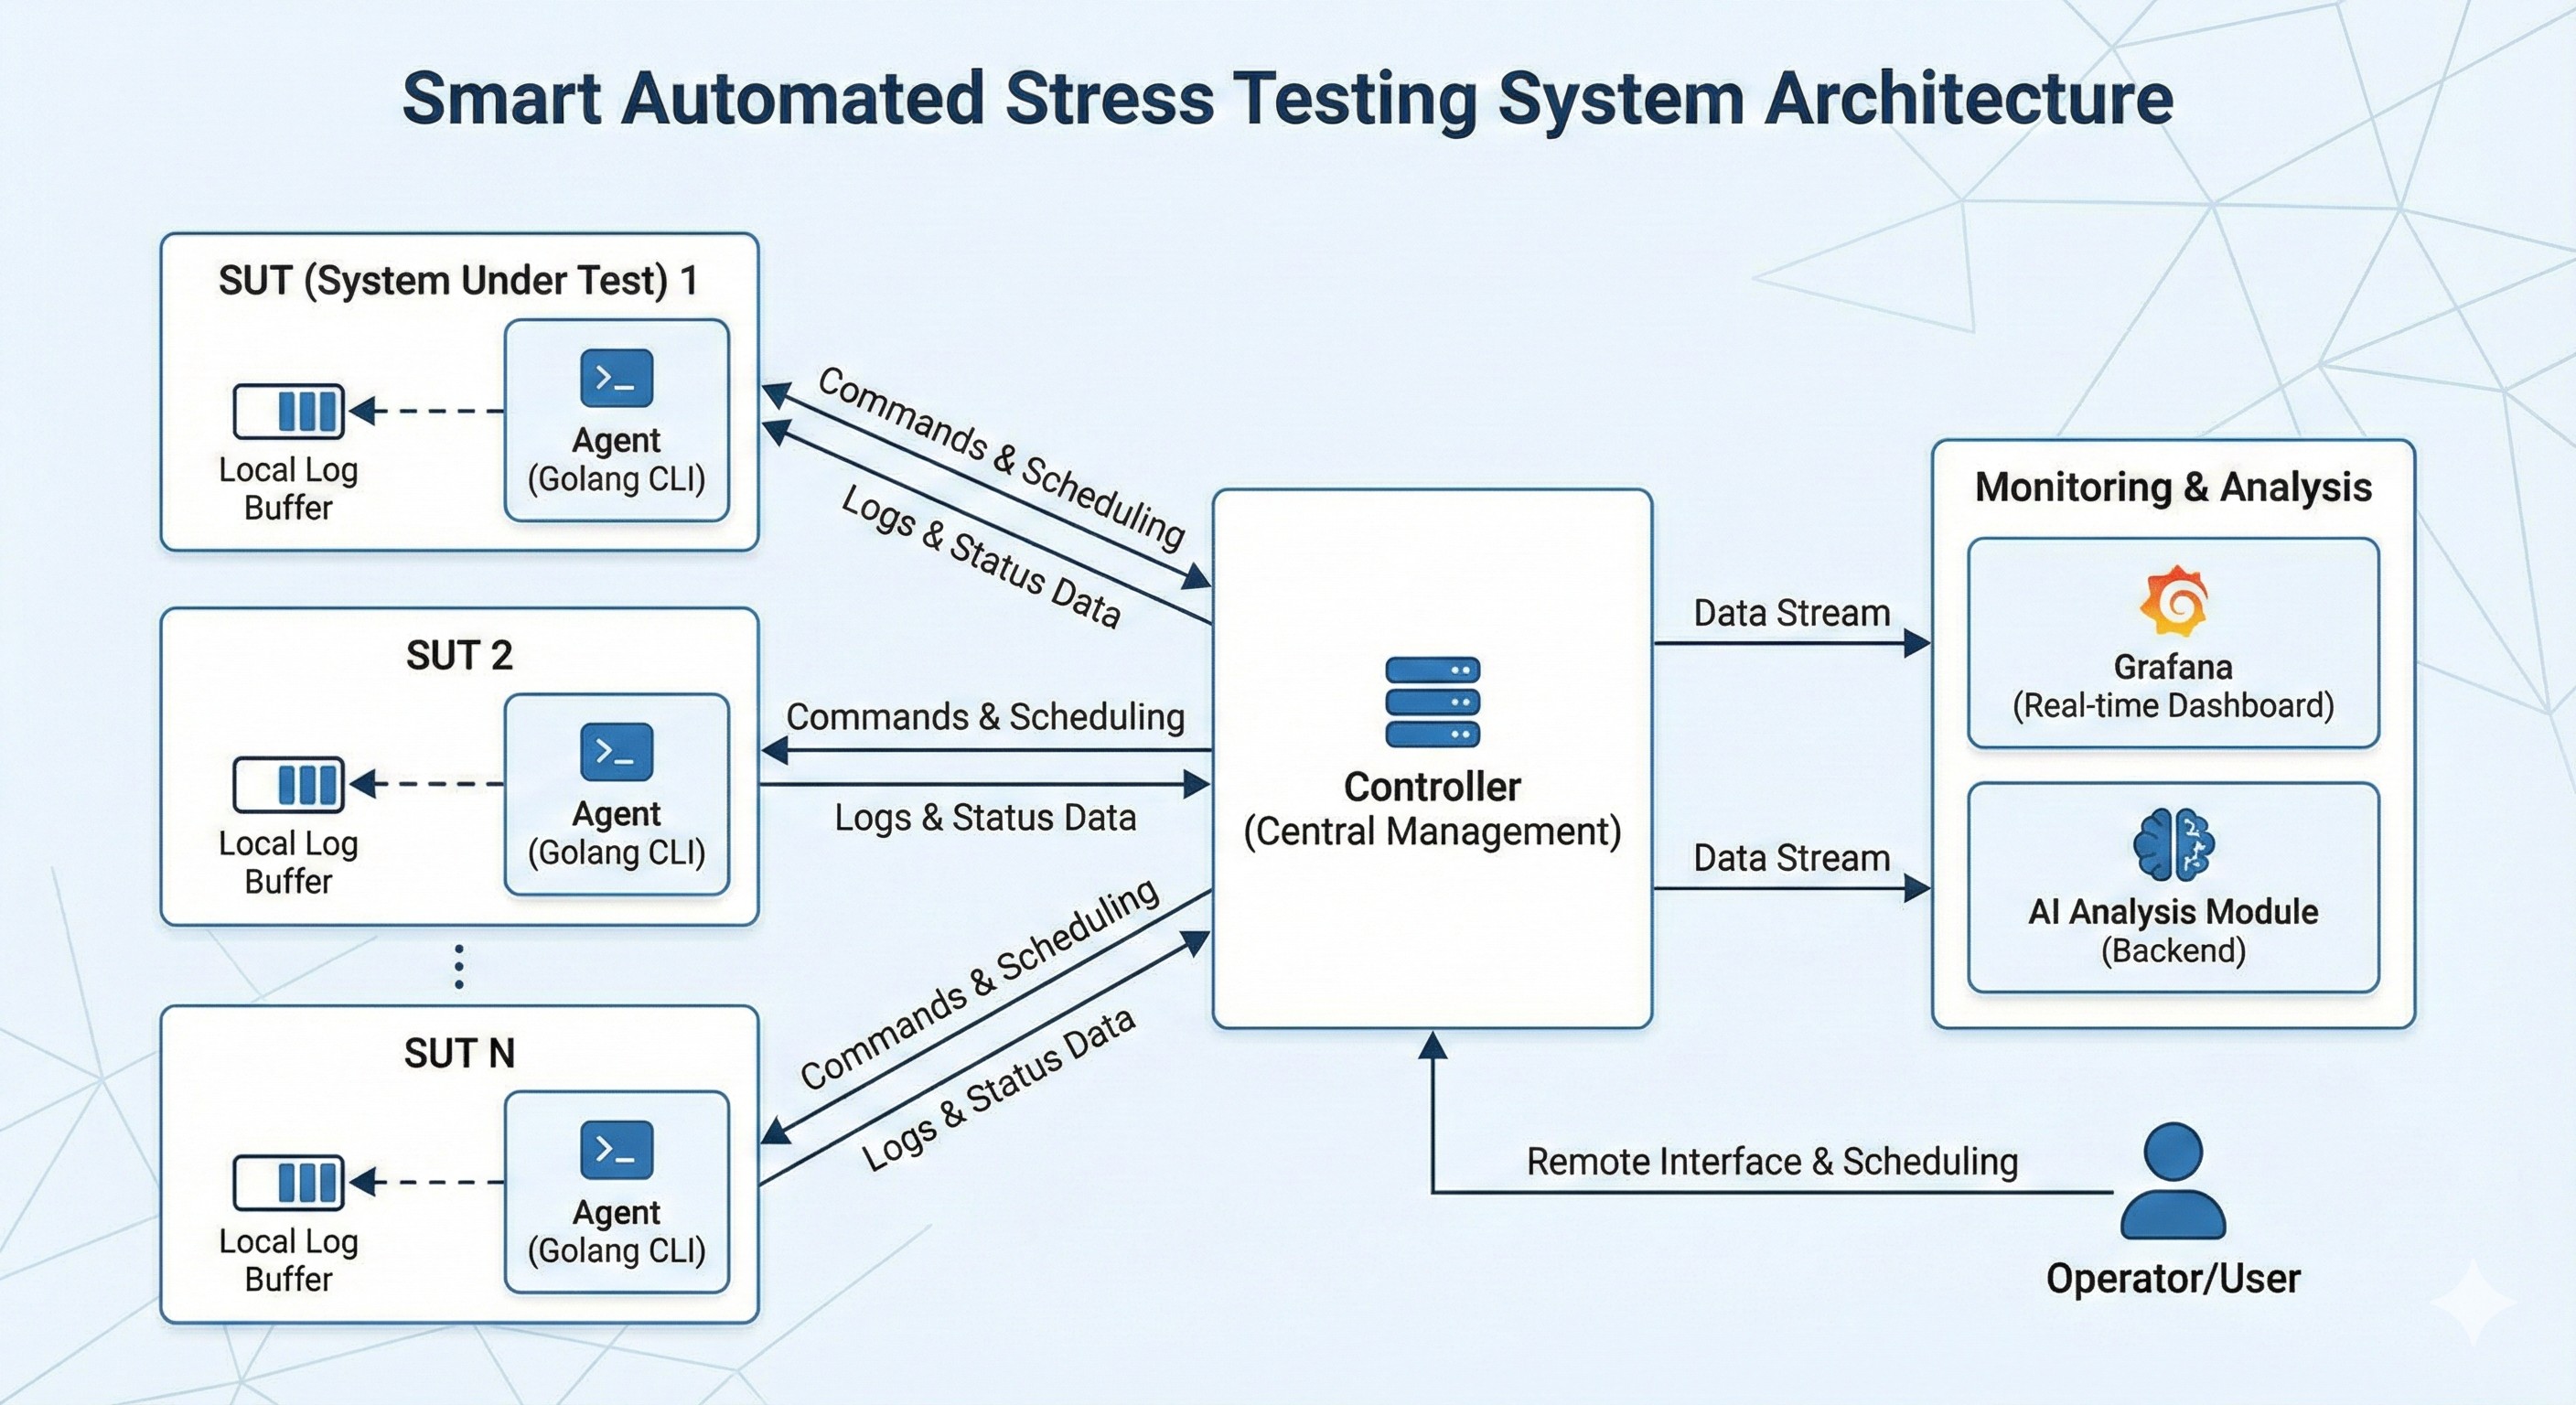 概念架構圖:呈現 operator、controller、agents/SUT 與 Grafana/AI backend 的資料流,不是部署規模或可用性證明。
Pre-test 與功率特徵建模
系統先逐步調整元件負載,觀察 load 與 power 的關係。公開描述中的模型形式包括:
CPU:近似線性反應
在觀測區間內,CPU 功率可用近似線性模型表達:
$$P_{CPU}(x) \approx ax+b$$
Memory/Ethernet:飽和型反應
Memory 與 Ethernet 在低負載區間上升較快,之後逐漸接近飽和。文章以 inverse-exponential/saturation curve 描述這種反應,但未公開完整公式、係數與 residual。
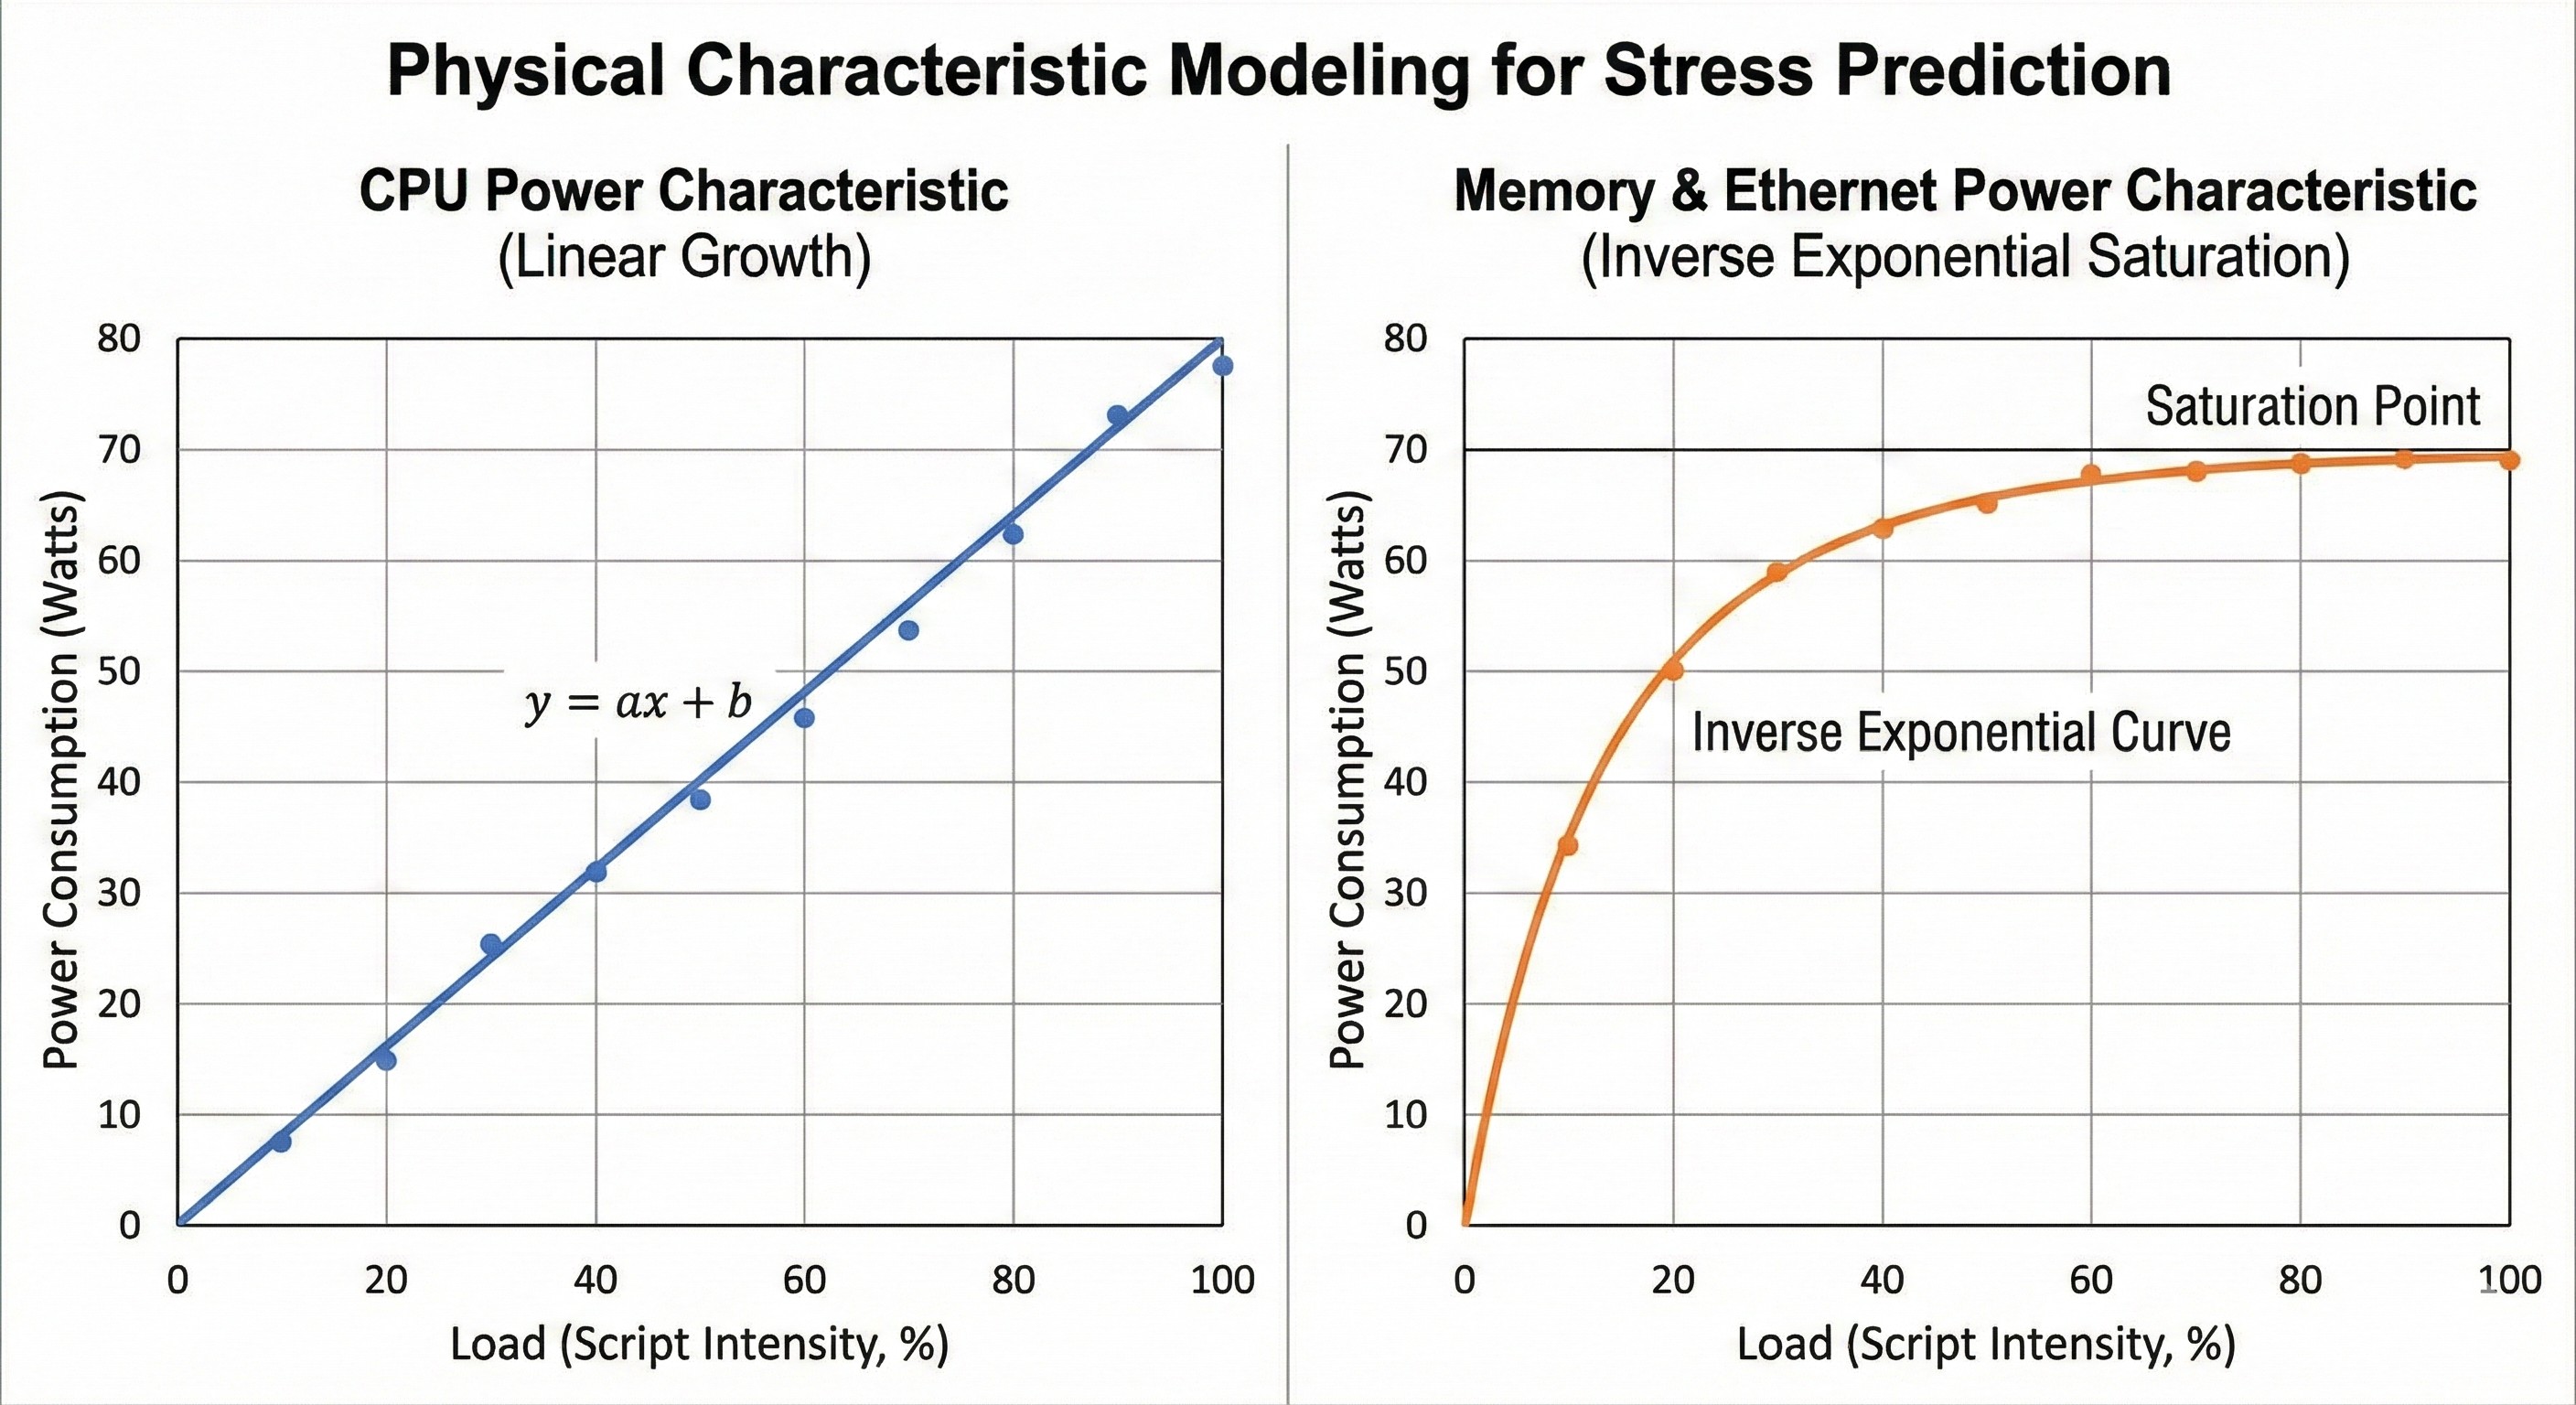 示意圖:說明線性與飽和型 response 的差異;圖中點位與曲線不視為公開量測資料。
GPU、RAM、FIO/storage I/O 與 Ethernet 都可作為 workload input,但公開資料只明確描述 CPU 與 Memory/Ethernet 的曲線形式,因此不把相同模型延伸到 GPU 或 I/O。
從目標瓦數反推 Workload Mix
使用者輸入目標 system wattage 後,演算法根據 pre-test 建立的 response 與各元件權重,選擇 CPU、GPU、Memory、FIO/I/O 與 Ethernet script 的候選強度。這個方法的目的,是比固定比例 script 更有系統地接近指定功率條件。
公開內容沒有 objective function、constraint、search strategy、模型誤差、target-power tolerance 或 across-platform 統計,因此這裡使用「推估/接近」而不是「精準命中」。正式驗證應比較 target 與 measured wattage 的 absolute/relative error,並分開報告不同配置與環境條件。
多維度 Grafana 結果回顧
原始設計希望把 temperature、fan speed、system power 與累積停留時間/頻率整合到同一張圖,降低長時間測試的閱讀成本。
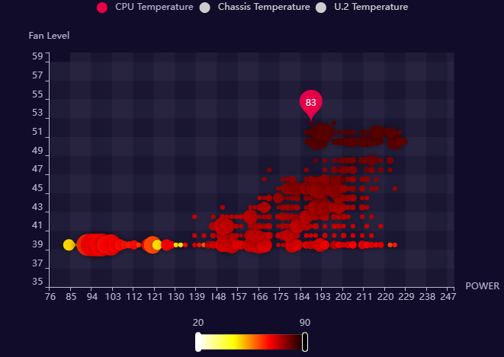 實際結果畫面:可見 power、fan level 與多組 temperature series。由於公開截圖的軸與 legend 未完全對應原始「四維」文字定義,這裡不指定每個視覺 encoding 的唯一語意。
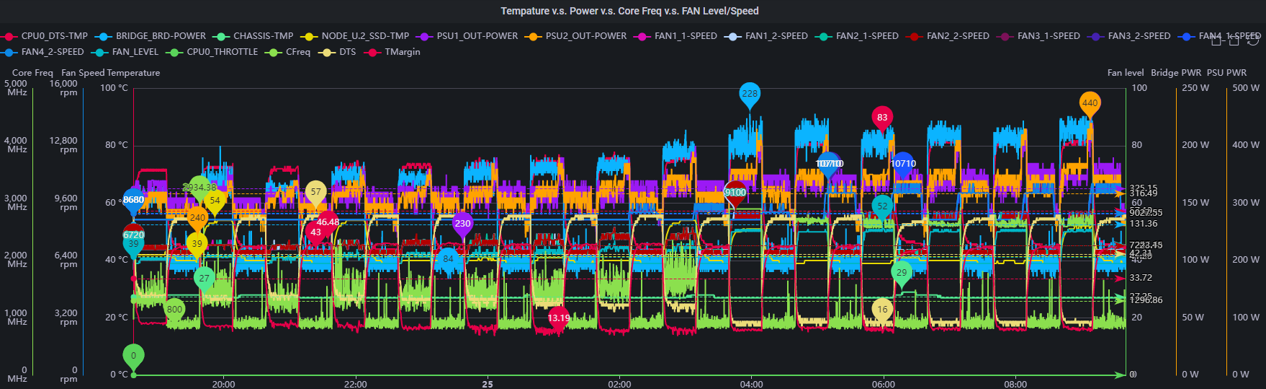 實際 dashboard:畫面包含多組溫度、fan speed/level、power、frequency 與 throttling 狀態;它證明該次畫面的資料範圍,不代表所有部署都固定提供相同欄位。
AI 輔助分析的邊界
系統架構保留將圖表或資料交給視覺 AI 模組做摘要與候選風險提示的路徑。公開內容未提供模型名稱、prompt、輸出範例、ground truth、準確率或 false-positive 評估,因此不宣稱 AI 已能自主診斷散熱風險或效能瓶頸。
較安全的定位是:AI 協助把長時間圖表轉成待人工確認的 observation;最終結論仍要回到原始 telemetry、測試條件、sensor validity 與工程門檻。
可驗證成果與限制
目前公開資料支持分散式 agent/controller 架構、pre-test 建模方法、target-power workload composition,以及 Grafana 結果畫面。它沒有提供 raw data、fit report、功率誤差分布、斷線復原測試、AI evaluation 或跨機種 benchmark。
下一步若要量化系統價值,應至少追蹤:
- Target wattage 的 MAE/relative error 與達標時間。
- 不同配置下模型 coefficient 與 residual 的穩定性。
- Agent disconnect 後 log completeness 與 recovery time。
- 圖表/AI observation 經工程師確認後的 precision、recall 與修訂率。
技術棧
Golang · Python · Linux · Server BMC/IPMI · Distributed agents · Mathematical modeling · Grafana · Stress workloads · CI/CD